几个做题的小技巧:
深度优先搜索 (depth first
search,dfs)
适用问题:能把待求解的问题分成不太多的步骤 ,每个步骤又只有不太多的选择 。
dfs 模板:
1
2
3
4
5
void dfs (int dep,...) dfs (dep+1 ,...);
它的本质上是一种走不通就掉头 的思想。有些问题在往下一步搜索时,每一步都出现很多分支,为了求得问题的解,我们必须对每一个分支都要试探,看看是否符合题目要求,若发现某一步试探不合要求,则停止从该分支往下的试探,立即返回到上一步去试探其它分支,直到找到问题的解。如果回溯到问题的初始状态之后还要返回,则表示该问题无解。
可行性剪枝 上下界剪枝
例题:P1219
(USACO1.5) 八皇后 Checker Challenge
思路
尝试一行一行 地放置皇后,如果某一个位置可以放置皇后,则搜索下一行 。当八行都搜索完成后则输出解并返回。
如何判断一个位置上能否放置皇后 呢? bool 数组?1 表示可以放,0 表示不能放?不仅效率低,正确性也没法保证。
行限制很好解决,因为我们一行一行放,只需要保证一行只放一个即可。
如果在同一列上,则列号相同; 用 bool vis[0][1-8]
数组来保存列限制,每次尝试在第 i 行第 j 列放置皇后前检查
vis[0][j] 是否已经被限制(是否等于 1 ),每次在第 i 行第 j 列放置皇后时,设置
vis[0][j]=1。 如果同在/斜线上的行列值之和相同; 用
bool vis[1][2-16] 数组来保存 斜线限制,每次尝试在第 i 行第
j 列放置皇后前检查 vis[1][i+j] 是否已经被限制(是否等于
1 ),每次在第 i 行第 j
列放置皇后时,设置 vis[1][i+j]=1。 如果同在\
斜线上的行列值之差相同; 用 bool vis[2][-7 - 7] 数组来保存
\斜线限制,每次尝试在第 i 行第 j 列放置皇后前检查
vis[2][i - j] 是否已经被限制(是否等于 1),每次在第 i 行第
j 列放置皇后时,设置 vis[2][i - j]=1。 可是 C++
不允许数组下标为负数,怎么办?把所有数值都加个 7 就行了!
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 #include <bits/stdc++.h> using namespace std;const int MAXN = 35 ;int n,ans,a[MAXN];bool vis[3 ][MAXN] = {0 };void print () for (int i = 1 ;i <= n;++i){printf ("%d " ,a[i]);void search (int i) if (i == n + 1 ){if (ans <= 3 )print ();return ;for (int j = 1 ;j <= n;++j)if (!vis[0 ][j] && !vis[1 ][i + j] && !vis[2 ][i - j + n - 1 ]){0 ][j] = vis[1 ][i + j] = vis[2 ][i - j + n - 1 ] = 1 ;search (i + 1 );0 ][j] = vis[1 ][i + j] = vis[2 ][i - j + n - 1 ] = 0 ;int main () search (1 );printf ("%d\n" ,ans);return 0 ;
每次递归进入深一层,进行标记;从深层返回后,清除标记。这个方法就叫做回溯。
洪水填充 (floodfiil) 思路
对于每个细胞数字 ,其处理逻辑都使一致的,都是先标记自己 ,然后尝试扩展到相邻点 ,那么就可以用递归的思路解决问题。
例题 P1451
求细胞数量
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 #include <bits/stdc++.h> using namespace std;const int MAXN = 105 ;int m,n;char field[MAXN][MAXN];int dx[]={1 ,-1 ,0 ,0 };int dy[]={0 ,0 ,1 ,-1 };int colorCount;void floodfill (int x,int y) 0 ;for (int k = 0 ;k < 4 ; ++k){int xx = x + dx[k];int yy = y + dy[k];if (xx > 0 && xx <= m && yy > 0 && yy <=n){if (field[xx][yy]>='1' && field[xx][yy] <='9' )floodfill (xx,yy);int main () for (int i = 1 ;i <= m;++i){for (int j = 1 ;j <= n; ++j){for (int i=1 ;i<=m;++i){for (int j=1 ;j<=n;++j){if (field[i][j]>='1' &&field[i][j]<='9' ){floodfill (i,j);return 0 ;
广度优先搜索算法
(breadth first search,bfs)
特点:先尝试在本层枚举,如果本层没有答案,则去下一层枚举下一层的所有可能性。
要了解广度优先搜索算法,首先要了解队列。
队列:
顺序队列 顺序队列的基本操作:(1)
初始化 :head = tail = 0,这时候队列中没有元素,为空。(2)x
元素入队 :q[tail++]=x;(3) 队首元素赋值给 a
并出队 :a=q[head++];(4)
队列为空的条件 :head==tail(5)
队列中元素个数 :tail-head当然也可以使用
STL 中的 queue 来实现。循环队列 具体循环队列的基本操作如下:“队列初始化”与“判断队列是否为空”与顺序队列是一样的 ;进队
(插入元素 x) :如果队列未满则执行
q[tail]=x;tail=(tail + 1)% m;
出队 :如果队列不为空,则返回队首元素
q[head],同时
head=(head + 1)% m。队列中元素个数 :(tail-head+m)% m;单调队列
单调队列是一种特殊的队列 ,它能在队列两端进行删除操作 ,并始终维护队列保持一种单调性 。
以单调递增队列为例,它要求队列中的元素始终保持单调递增,新元素入队时,先将队尾比新元素值更大的元素剔除出队列后,再将新元素入队 。这保证了队列中所有元素单调递增 。
例如:队列中元素 10 98 100 105 ,则 99
入队时,先将 100 和 105 剔除出队,再将 99 入队,队列中的元素为:10 98 99 。
顺序队列模板题:B3616 【模板】队列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 #include <bits/stdc++.h> using namespace std;int q[10005 ];int tail,head;int n,x,num;int main () while (n--){if (num==1 ){else if (num==2 ){if (head==tail)puts ("ERR_CANNOT_POP" );else head++;else if (num==3 ){if (head==tail)puts ("ERR_CANNOT_QUERY" );else cout<<q[head]<<endl;else cout<<tail-head<<endl;return 0 ;
单调队列模板题:P1886【模板】单调队列 /
滑动窗口 直接放代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #include <bits/stdc++.h> using namespace std;int n,k;int nums[20000005 ];int q[20000005 ],head,tail;int q1[20000005 ],head1,tail1;int >v1,v2;int main () for (int i = 0 ;i < n;++i)cin >> nums[i];for (int i = 0 ;i < n;++i){while (tail - head != 0 && nums[q[tail - 1 ]] <= nums[i])tail--;while (tail1 - head1 != 0 && nums[q1[tail1 - 1 ]] >= nums[i])tail1--;while (q[head] <= i - k)head++;while (q1[head1] <= i - k)head1++;if (i >= k - 1 ){1. push_back (nums[q[head]]);2. push_back (nums[q1[head1]]);for (int i = 0 ;i < v2. size ();++i)cout << v2[i] << ' ' ;for (int i = 0 ;i < v1. size ();++i)cout << v1[i] << ' ' ;return 0 ;
单调队列的性质: 对单调递增队列而言: 元素 k
入队时 ,其在单调队列中左边的元素即为元素 k
入队前的所有元素中,从右往左第一个比 k 小的元素。 元素 k
出队时 ,将其“挤”出单调队列的元素,即为在 k
之后入队的所有元素中,第一个小等于 k 的元素。
bfs 模板:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
void bfs () while (队列非空)
例题:P1443
马的遍历 一道简单题,用来理解一下广度优先搜索算法。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 #include <bits/stdc++.h> using namespace std;int n,m,x,y;int board[405 ][405 ];int dx[] = {-2 ,-2 ,-1 ,-1 ,1 ,1 ,2 ,2 };int dy[] = {-1 ,1 ,-2 ,2 ,-2 ,2 ,-1 ,1 };void bfs (int startX,int startY) memset (board,-1 ,sizeof (board));int >q;push (startX);push (startY);0 ;while (!q.empty ()){int x = q.front ();pop ();int y = q.front ();pop ();for (int i = 0 ; i < 8 ;++i){int xx = x + dx[i];int yy = y + dy[i];if (xx > 0 && xx <= n && yy > 0 && yy <= m && board[xx][yy] == -1 ){1 ;push (xx);push (yy);int main () scanf ("%d%d%d%d" ,&n,&m,&x,&y);bfs (x,y);for (int i = 1 ;i <= n;++i){for (int j = 1 ;j <= m;++j){printf ("%-5d" ,board[i][j]);printf ("\n" );return 0 ;
下面再看一个例子:P1141 01 迷宫
思路
我们可以发现,能移动到的格子数是成块出现的,所以对于每块,我们只需要求出其中的一个格子即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 #include <bits/stdc++.h> using namespace std;int maze[1005 ][1005 ];int color[1005 ][1005 ];int n,m;int nextColor;int colorCount[1000005 ];const int dx[4 ] = {0 ,1 ,0 ,-1 };const int dy[4 ] = {1 ,0 ,-1 ,0 };int bfs (int x,int y) if (color[x][y] != -1 ){return colorCount[color[x][y]];int count = 1 ;int >q;push (x);push (y);while (!q.empty ()){front ();pop ();front ();pop ();for (int i = 0 ; i < 4 ;++i){int nx = x + dx[i];int ny = y + dy[i];if (!(nx > 0 && nx <= n && ny > 0 && ny <= n))continue ;if (color[nx][ny] == -1 && maze[nx][ny] != maze[x][y]){push (nx);push (ny);return count;int main () for (int i = 1 ;i <= n;++i){for (int j = 1 ; j <= n;++j){char c;'0' ;memset (color,-1 ,sizeof (color));0 ;for (int i = 0 ;i < m;++i){int x,y;bfs (x,y) << endl;return 0 ;
接下来是一个复杂一点的问题:P1379 八数码难题
思路 把状态用字符串压缩,然后使用广搜的方法来考虑方案数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 #include <bits/stdc++.h> using namespace std;struct Step {int num;int x,y;int dx[] = {-1 ,1 ,0 ,0 };int dy[] = {0 ,0 ,-1 ,1 };int main () "123804765" ;for (int i = 0 ;i <= 8 ;++i){if (start[i] == '0' ){int x = i / 3 ;int y = i % 3 ;push ({0 ,start,x,y});insert (start);while (!q.empty ()){front ();pop ();if (p.status == end){return 0 ;int x = p.x;int y = p.y;int pos = x * 3 + y;for (int k = 0 ;k < 4 ;++k){int xx = x + dx[k];int yy = y + dy[k];if (xx >= 0 && xx <= 2 && yy >= 0 && yy <= 2 ){int nextpos = xx * 3 + yy;swap (t[pos],t[nextpos]);if (s.count (t) == 0 ){push ({p.num + 1 ,t,xx,yy});insert (t);swap (t[pos],t[nextpos]);return 0 ;
前缀和 & 差分
用于求区间和。
1 for (int i=1 ;i<=n;i++) pre[i]=pre[i-1 ]+a[i];
前缀和模板题:B3612
【深进 1. 例 1】求区间和
1 2 3 4 5 6 7 8 9 10 11 12 13 14 #include <bits/stdc++.h> using namespace std;int n,a[100005 ],m,l,r,pre[100005 ];int main () for (int i = 1 ;i <= n;++i)cin >> a[i];for (int i = 1 ;i <= n;++i)pre[i] = pre[i - 1 ] + a[i];while (m--){1 ] << endl;return 0 ;
1 for (int i=1 ;i<=n;++i)d[i] = a[i]-a[i-1 ];
可快速修改一个区间里的数,使这个区间里的数字同时增加 k P2367 语文成绩
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #include <bits/stdc++.h> using namespace std;int n,p,nums[5000005 ],x,y,z,ans = 0x7fffffff ;int d[5000005 ];int main () for (int i = 1 ;i <= n;++i){1 ];while (p--){1 ] -= z;for (int i = 1 ;i <= n;++i)nums[i] = nums[i - 1 ] + d[i];for (int i = 1 ;i <= n;++i)if (nums[i] < ans)ans = nums[i];return 0 ;
栈 & 链表
栈是限定仅在标为进行插入或删除操作的线性表。 栈的模板题:B3614 【模板】栈
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #include <bits/stdc++.h> using namespace std;unsigned long long s[1000005 ];unsigned long long t,n,ans,tail=0 ;int main () while (t--){while (n--){if (s1=="push" ){else if (s1=="pop" ){if (tail==0 )cout<<"Empty" <<endl;else tail--;else if (s1=="query" ){if (tail==0 )cout<<"Anguei!" <<endl;else cout<<s[tail-1 ]<<endl;else cout<<tail<<endl;while (tail!=0 )tail--;return 0 ;
经典问题:B2165
括号匹配
思路
对于每一个左括号 ,一定是越靠后出现的越先匹配 。符合栈的性质。
考虑用栈来维护当前未匹配的左括号:
维护一个栈 ,从左到右扫序列,如果当前括号是左括号则将该位置加入栈中,如果是右括号,则该右括号与栈顶位置的左括号匹配,输出这对匹配括号的位置并删除栈顶的左括号。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 #include <bits/stdc++.h> using namespace std;char >stk;int n;char ch[128 ];bool check (string s) while (!stk.empty ())stk.pop ();for (char c:s){if (ch[c]==0 ){push (c);else if (!stk.empty () && stk.top () == ch[c]){pop ();else {return false ;return stk.empty ();int main () ')' ]='(' ;']' ]='[' ;'}' ]='{' ;while (n--){puts (check (s)?"YES" :"NO" );return 0 ;
查询序列中第 i O (n )
1
2
3
4
5
6
int GetPos (int pos) int hd=Head;for (int j=1 ;j<pos;j++)hd=nxt[hd];return hd;
在第 i v O (n )i O (n )
1
2
3
4
5
6
7
void InsertValue (int pos,int val) int p=GetPos (pos-1 );
删除序列中的第 i O (n )i O (n )
1
2
3
4
5
void DeleteValue (int pos) int p=GetPos (pos-1 );
当然也可以使用数组模拟。 当然也可以使用 STL 中的 list 来实现。
二分 & 贪心
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 #include <bits/stdc++.h> using namespace std;#define ll long long const int MAXN = 100010 ;bool check (ll k) int cnt = 0 ;0 ;for (int i = 1 ;i <= n;++i){if (now>=k){return cnt >= m;int main () for (int i = 1 ;i <= n;++i){max (l,f[i]);while (r - l > 1 ){1 ;if (check (mid))l = mid;else r = mid;return 0 ;
分治
分治三步法 :
把问题的实例划分成子问题
递推解决子问题
合并子问题的解得到原问题的解 经典问题:P1908 逆序对
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 #include <bits/stdc++.h> using namespace std;#define int long long int a[500005 ],t[500005 ],n;long long ans;void merge (int left,int right) int i,j,mid,tmp;2 ;1 ;while (i <= mid&& j <= right){if (a[i]<=a[j]) t[tmp++] = a[i++];else {1 ;while (i <= mid) t[tmp++] = a[i++];while (j <= right)t[tmp++] = a[j++];for (i = left;i <= right;++i){void mergesort (int left,int right) if (left < right){int mid;2 ;mergesort (left,mid);mergesort (mid+1 ,right);merge (left,right);int read () int x = 0 ,f = 1 ;char c = getchar_unlocked ();while (c < '0' || c > '9' ){if (c == '-' )f = -1 ;getchar_unlocked ();while (c >= '0' && c <= '9' ){10 + c - '0' ;getchar_unlocked ();return x * f;void write (int x) if (x < 0 )putchar ('-' ),x = -x;if (x > 9 )write (x / 10 );putchar (x % 10 + '0' );signed main () read ();for (int i=1 ;i<=n;++i)a[i] = read ();mergesort (1 ,n);write (ans);return 0 ;
1 2 3 4 5 6 long long fast_power (int a,int b) if (b==0 )return 1ll ;long long temp = fast_power (a,b>>1 );if (b&1 )return (temp*temp%p)*a%p;return temp*temp%p;
例题:B2163
棋盘覆盖
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 #include <bits/stdc++.h> using namespace std;typedef long long ll;const ll MAXN = (1 <<10 ) + 5 ;1 ;void f (int x,int y,int n,int sx,int sy) if (n == 1 )return ;int r;if (sx >= x + n / 2 ){if (sy >= y + n / 2 )r = 3 ;else r = 1 ;else {if (sy >= y + n / 2 )r = 2 ;else r = 0 ;if (r != 0 )a[x + n / 2 - 1 ][y + n / 2 - 1 ] = now;if (r != 1 )a[x + n / 2 ][y + n / 2 - 1 ] = now;if (r != 2 )a[x + n / 2 - 1 ][y + n / 2 ] = now;if (r != 3 )a[x + n / 2 ][y + n / 2 ] = now;if (r == 0 ) f (x,y,n / 2 ,sx,sy);else f (x,y,n / 2 ,x + n / 2 - 1 ,y + n / 2 - 1 );if (r == 1 ) f (x + n / 2 ,y,n / 2 ,sx,sy);else f (x + n / 2 ,y,n / 2 ,x + n / 2 ,y + n / 2 - 1 );if (r == 2 ) f (x,y + n / 2 ,n / 2 ,sx,sy);else f (x,y + n / 2 ,n / 2 ,x + n / 2 - 1 ,y + n / 2 );if (r == 3 ) f (x + n / 2 ,y + n / 2 ,n / 2 ,sx,sy);else f (x + n / 2 ,y + n / 2 ,n / 2 ,x + n / 2 ,y + n / 2 );int main () 1 << k;memset (a,-1 ,sizeof (a));f (1 ,1 ,n,x,y);0 ;for (int i = 1 ;i <= n;++i){for (int j = 1 ;j <= n;++j){' ' ;return 0 ;
树 & 二叉树
树 树的定义 一棵树是由 n n > 0
每个元素称为结点 (node)
有一个特定的结点,称为根结点或树根(root)
除根结点外,其余结点能分成 m m ≥ 0T 0 T 1 T 2 T m − 1
树的性质
n n − 1树上任意两个点一定是相互可达的(连通),树是一张连通图。
树上一定不存在环。
每个节点(除根结点外)都有且仅有一个父亲结点,每个结点可以有多个儿子结点。
n n − 1
二叉树(binary tree, 简写成
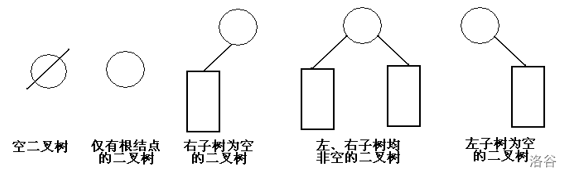
BT)是一种特殊的树型结构。二叉树的每个结点最多有两个子结点。每个结点的子结点分别称为左孩子、右孩子,它的两棵子树分别称为左子树、右子树。二叉树有
5 种基本形态:k 2k
个结点,我们称之为满二叉树 。 给定一棵包含 2k 个结点的满二叉树
(k 1 , 2 , 3 …,则结点 i 的左右子结点编号分别为 2 × i 和 2 × i + 1 。 结点 i $\frac{i}{2}$ 。 深度为 k n k 1 到 n 完全二叉树 。
满二叉树都是完全二叉树 。但完全二叉树不一定 都是满二叉树。
【性 质 1】
在二叉树的第 i 2i − 1
个结点(i ≥ 1
证明:很简单,用归纳法:当 i = 12i − 1
显然成立;现在假设第 i − 1i − 12i –2
个结点。由于二叉树的每个结点的度最多为 2 ,故在第 i i − 12 倍, 即 2 × 2i − 2i –1 。
【性 质 2】 深度为
k k ≥ 120 + 21 + … + 2k − 1k
二叉树常见的递归遍历方式有先序遍历、中序遍历和后序遍历 。
先序遍历:(PreOrder)PreOrder(T T T T T T T T T T T
图更常用邻接表来存储。
也就是每个结点维护一个链表,这个链表存储着以当前结点为起点的边。
简单的说,就是用链表把同一个结点连出的边串起来。
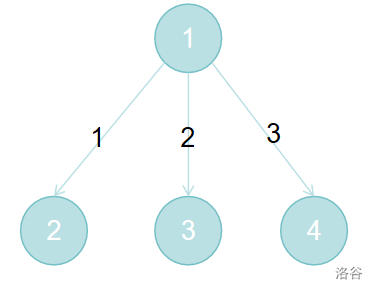
1 号点连出去的第一条边为 1 号边1 号边的下一条边为 2 号边,2
号边的下一条边为 3 号边1 号边连向的点为 2 号点;2
号边连向的点为 3 号点,3 号边连向的点为 4 号点。还可以根据需要记录每条边的权值。
树的存储 有根树 :(题目已经告知根节点 ,并且树边按照父亲
- 儿子顺序 给出)直接用邻接表有向图 存储。
遍历:
1 2 3 4 5 6 7 void dfs (int now) for (int i=first[now];i;i=nxt[i]){dfs (to[i]);
题目已经虽已告知根节点 ,但树边有可能按父亲
- 儿子顺序给出,也有可能按儿子 - 父亲顺序给出 。
或者题目未告知根节点 ,每个点都可以动态成为根节点,把根节点拎起来,就形成一棵有根树了。
直接用邻接表无向图 存储。 所谓的无向图,就是在加边
(a , b ) 时,既加 a b (a , b ) ,也加 b a (b , a ) 。 遍历:
1 2 3 4 5 6 7 8 void dfs (int now,int fa) for (int i=first[now];i;i=nxt[i]){if (to[i]==fa) continue ;dfs (to[i],now);
P5018 [NOIP 2018
普及组] 对称二叉树
思路 用链式存储二叉树。
暴力算法:遍历每一棵子树 ,判断其是否为“对称二叉树”。如果是,用该子树的大小(结点个数)去“打擂”刷新答案。
因此考虑可以先遍历一遍二叉树,求出以每个结点 i 为根的子树的大小
size[i]。
1 size[i]=1 +size[lson[i]]+size[rson[i]]
那么如何判断一棵子树是否是“对称二叉树”呢?我们发现,以 i bool check(int u,int v)
实现判断以 u v u v
val[u]=val[v]以 lson[u] 为根的子树和以 rson[v]
为根的子树对称。(子问题)
以 rson[u] 为根的子树和以 lson[v]
为根的子树对称。(子问题)
考虑递归求解。递归边界为遇到空子树 。
1 2 3 4 5 6 7 bool check (int u,int v) if (u==-1 &&v==-1 ) return true ;if (u==-1 ||v==-1 ) return false ;if (val[u]==val[v] && check (f[u][0 ],f[v][1 ]) && check (f[u][1 ],f[v][0 ])) return true ;return false ;
这看似纯模拟的算法非常暴力,可能要检查很多的子树,而且有大量的重复检查 ,一个结点可能被比对很多次。要想通过
106
的测试数据是万不可能的。能否想想看有什么可以优化的地方?
如果两棵子树结点数不同 ,就一定不对称 !
1 2 3 4 5 6 7 bool check (int u,int v) if (u==-1 &&v==-1 ) return true ;if (u==-1 ||v==-1 ||size[u]!=size[v]) return false ;if (val[u]==val[v] && check (f[u][0 ],f[v][1 ]) && check (f[u][1 ],f[v][0 ])) return true ;return false ;
别小看这么一个优化,他可以在二叉树的结构不那么对称时,直接免去很多的无用的判断 。最坏情况会出现在二叉树的结构本身就非常“对称”,并且它的众多子树结构都非常对称。也就是当二叉树尽量为满二叉树或完全二叉树时,比对两棵子树是否对称的操作会最为频繁 !在这样情况下的时间复杂度?用比较两个结点
v a l O (1)比较次数最多的是满二叉树最后一层的结点 ,比较次数为树高
logn 。所以总的时间复杂度不超过
O (n logn
多模拟样例 (包括自构的)往往能给我们带来解决问题的方法以及一些优化方向。学会分析时间复杂度 很重要。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 #include <bits/stdc++.h> #define maxn 1000010 int f[maxn][2 ],val[maxn],size[maxn];int n,l,r;void dfs (int k) 1 ;if (f[k][0 ]!=-1 ){dfs (f[k][0 ]);0 ]];if (f[k][1 ]!=-1 ){dfs (f[k][1 ]);1 ]];int max (int a,int b) return a>b?a:b;bool check (int u,int v) if (u==-1 &&v==-1 ) return true ;if (u==-1 ||v==-1 ||size[u]!=size[v]) return false ;if (val[u]==val[v] && check (f[u][0 ],f[v][1 ]) && check (f[u][1 ],f[v][0 ])) return true ;return false ;int main () scanf ("%d" ,&n);for (int i=1 ;i<=n;i++) scanf ("%d" ,&val[i]);for (int i=1 ;i<=n;i++){scanf ("%d%d" ,&f[i][0 ],&f[i][1 ]);dfs (1 );int ans=0 ;for (int i=1 ;i<=n;i++)if (check (f[i][0 ],f[i][1 ]))max (size[i],ans);printf ("%d" ,ans);return 0 ;
P5658 [CSP-S 2019]
括号树
思路 我们先来分析链的情况。这还是一条非常友好的“链”,f i i − 1i i l r [l , r ] 的子括号序列。
对于每一个子序列,用栈来暴力判断其是否为合法括号序列 ,如是,则计数器加一。
对于每一个左括号,一定是越靠后出现的越先匹配 。符合栈的性质。
考虑用栈来维护当前未匹配的左括号:
维护一个栈,从左到右扫序列,如果当前括号是左括号则将该位置加入栈中,如果是右括号,则该右括号与栈顶位置的左括号匹配,输出这对匹配括号的位置并删除栈顶的左括号。
时间复杂度为 O (n 4 )20 分了。
我们发现其中还是存在大量的重复运算: 每次枚举 1 − i
的子段,并判断每个子段是否为合法括号序列。
对于计数类问题,很常见的优化方式是不直接枚举 +
判断,而是处理出每个元素对答案的贡献。
或者对本题而言,就是处理出以每个括号结尾的合法子段是多少 (w [i ]sum[i]=w[1]+w[2]...+w[i],最终的 sum
数组即为原题描述中要求的 k 1 k 2 k n w [i ]1 ) 例子 1 :()()() 我们发现,i = 21 。而 i = 4[3, 4]
就有一个满足要求的括号序列,在合并上前面的成为 [1, 4] ,同样满足,于是对答案的贡献值就为
2 ,再加上前面 [1, 2] 本身有的括号序列,总共为 3 。 i = 6 时同理,总共的贡献值为 3 ,加上前面的有 3 + 3=6
种。其他位置均没有贡献。 换句话说,i 为 1−6 时对答案的贡献分别为 0 ,1 ,0 ,2 ,0 ,3 ,合并后的总答案为 0 ,1 ,1 , 3 ,3 ,6 。 例子
2 : ())()
继续前面的思想,i = 21 。而 i = 3i = 5i = 3[1, 3] 不匹配,导致 [1, 5]
成不了一个匹配的括号序列。故对答案的贡献仍为 1 。i 1 − 5 时对答案的贡献分别为 0, 1, 0, 0, 1 ,合并后的总答案为 0, 1, 1, 1, 2 。
例子 3 : ()(())
接着刚刚的分析,i = 21 ,而 i = 5i = 3[1, 5] 不能匹配,所以贡献仍为 1 。 当 i = 6[1, 2] 是匹配的。故 [1, 2], [3, 6]
能合成一个匹配的序列,故对答案贡献为 2 。 i 1 − 6 时对答案的贡献分别为 0, 1, 0, 0, 1, 2 ,合并后的总答案为 0, 1, 1, 1, 2, 4 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 #include <bits/stdc++.h> #define maxn 500010 using namespace std;int fa[maxn],nxt[maxn],first[maxn],to[maxn],st[maxn],top,n,dad,num;char s[maxn];long long w[maxn],sum[maxn],ans;void add (int a,int b) void dfs (int k) int tmp=0 ;if (s[k]=='(' )0 ;else if (top){+1 ;else {0 ;for (int i=first[k];i;i=nxt[i])dfs (to[i]);if (s[k]=='(' ) --top;else if (tmp) st[++top]=tmp;int main () scanf ("%d" ,&n);getchar ();scanf ("%s" ,s+1 );for (int i=1 ;i<n;i++){scanf ("%d" ,&dad);+1 ]=dad;add (dad,i+1 );dfs (1 );for (int i=1 ;i<=n;i++)printf ("%lld" ,ans);return 0 ;
并查集
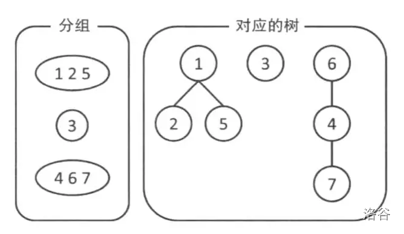
并查集是一种用来管理元素分组情况的数据结构。并查集可以高效地进行如下操作:
查询元素 a b
合并元素 a b
并查集也是使用树形结构实现的,我们将同一个集合内的元素组成一棵树,我们不关心树的形态如何。但这棵树需要支持“查找树根”的操作。
我们把“树根”当作每个集合的“代表元”,a 和 b 在同一个集合内当且仅当 a b
因为对于每个结点,我们要查询它所在的集合“代表元”(即树根),一定都只会“往上”走,而不会“往下”走。
对每个结点 i fa[i],根节点的父亲结点定义为其本身。
初始状态下,每个点都占山为王,自成一个集合:
1 for (int i=1 ;i<=n;i++) fa[i]=i;
查询 a
1 2 3 4 5 int find (int a) if (fa[a]==a) return a; return find (fa[a]);
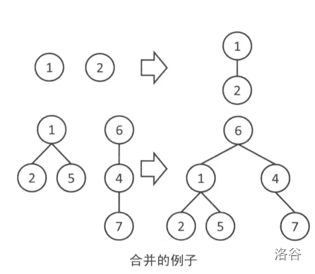
要将 a b a b
1 2 3 4 5 6 void join (int a,int b) int f1=find (a),f2=find (b);if (f1==f2) return ;
路径压缩
我们虽然不关心树的形态,但我们仍然希望树尽量越矮越好 ,这样不至于在“往上爬”的过程中耗费太多的时间。
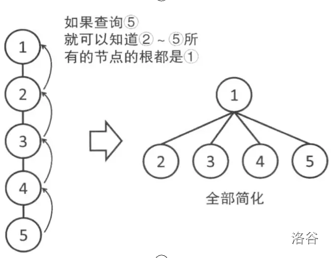
在查询过程中向上经过的所有的节点,都改为直接连到根上 :路径压缩 :
每次查询时将路径上所经过的点记录下来,查询到根节点后,让这些点直接连向根节点?
不必那么麻烦,递归实现,毫不费力:
1 2 3 4 5 int find (int a) if (fa[a]==a) return a; return fa[a]=find (fa[a]) ;
对于每棵树,记录这棵树的高度,合并时如果两棵树的高度不同,从高度小的向高度大的连边。
使用按秩合并和路径压缩的并查集,每次查询的时间复杂度可以证明为一个小于
logn 的数。
放一道模板题:P3367
【模板】并查集 没啥好说的,直接放代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 #include <bits/stdc++.h> using namespace std;const int MAXN=2E5 +5 ;int n,m,op,x,y,fa[MAXN];int find (int x) if (x==fa[x])return x;return fa[x]=find (fa[x]);void join (int u,int v) find (u)]=find (v);int main () scanf ("%d%d" ,&n,&m);for (int i=1 ;i<=n;++i)fa[i]=i;while (m--){scanf ("%d%d%d" ,&op,&x,&y);if (op==1 ){join (x,y);else {puts ((find (x)==find (y))?"Y" :"N" );return 0 ;
例题:P1551
亲戚
思路 由于“有亲戚关系”具有传递性。因此很自然想到,用并查集来维护具有亲戚关系的集合。
每一次申明一组新的亲戚关系,相当于将两个人的组合进行“并集”操作。
每次查询两个人是否具有亲戚关系,实际上是两次“查集”操作。查询两人所在树的树根是否相同。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #include <bits/stdc++.h> using namespace std;const int MAXN=20010 ;int n,m,q,fa[MAXN],a,b;int find (int x) if (x==fa[x])return x;return fa[x]=find (fa[x]);void add (int u,int v) find (u)]=find (v);int main () scanf ("%d%d%d" ,&n,&m,&q);for (int i=1 ;i<=n;++i)fa[i]=i;for (int i=1 ;i<=m;++i){scanf ("%d%d" ,&a,&b);add (a,b);while (q--){scanf ("%d%d" ,&a,&b);if (find (a)==find (b))puts ("Yes" );else puts ("No" );return 0 ;
堆
二叉堆是一棵完全二叉树 ,并且满足堆(小根堆)的性质:
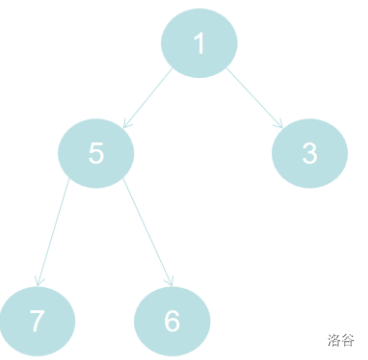
设 P i P k P f a k 3,5,1,7,6 构成的二叉堆。不是唯一 的,但我们不关心堆的形态 ,只需要它满足堆的性质 即可。这样所有的结点权值都小于等于它的子孙结点,因此整棵二叉树的根节点(堆顶元素)一定是所有结点中权值最小 的结点。
堆需要支持的操作:
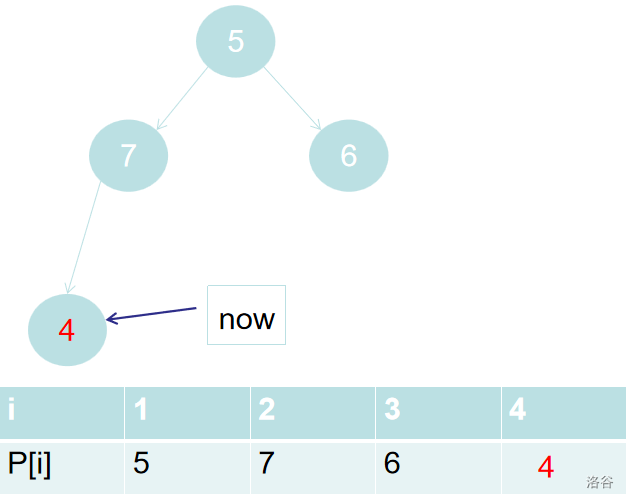
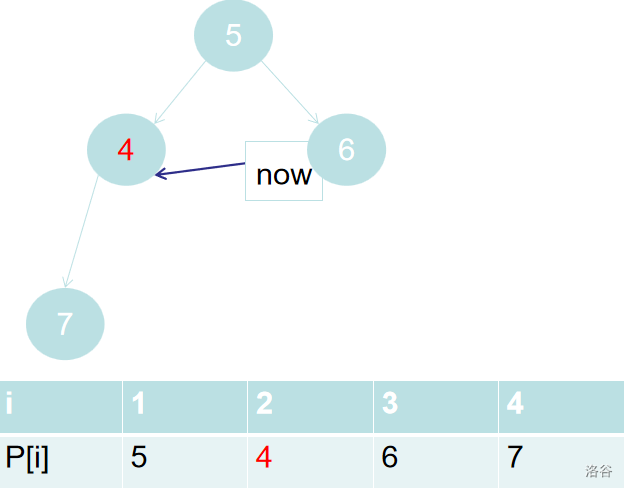
取出堆顶元素 并维护堆的平衡 。插入一个新元素 并维护堆的平衡 。s i z e 5 ,表示堆中一共有五个元素。1 后,维护堆的平衡靠以下操作实现:将 P s i z e P 1 s i z e − 11 号结点置为“当前结点”
当“当前结点”为非叶子结点,且比它左右儿子结点权值较小者更大时,重复执行以下操作:
将“当前结点”与其左右结点权值较小者交换位置,并将交换后的新位置置为“当前结点”。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 int pop () int now=1 , nxt, res= p[1 ];1 ] = p[size--];while (now * 2 <= size)2 ;if (nxt < size && p[nxt + 1 ] < p[nxt]) nxt++;if (p[now] <= p[nxt]) break ;swap (p[now], p[nxt]);return res;
如果说删除堆顶元素后维护堆的平衡是靠“下沉”来实现的,那么往堆中添加新元素则是通过“上浮”来实现维护堆平衡的。
往堆尾添加一个新结点,并将该节点置为“当前结点”。
当“当前结点”不是根结点且比其父亲结点权值更小时 ,重复执行以下操作:交换它们的位置 ,并将父亲结点置为新的“当前结点” 。
1 2 3 4 5 6 7 8 9 10 11 12 13 void push (int d) int now, nxt;while (now > 1 )1 ;if (p[now] >= p[nxt]) break ;swap (p[now], p[nxt]);
STL 的使用: heap(常数小)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 #include <algorithm> struct node {int dis,num;bool operator <(const node &c)return dis<c.dis;bool cmp (const node &c,const node &d) return c.dis>d.dis;make_heap (a+1 ,a+size+1 );make_heap (a+1 ,a+size+1 ,cmp);1 ];pop_heap (a+1 ,a+size+1 ,cmp);push_heap (a+1 ,a+size+1 ,cmp);sort_heap (a+1 ,a+size+1 ,cmp);struct node {int dis,num;bool operator <(const node &c)return dis<c.dis;bool cmp (const node &c,const node &d) return c.dis>d.dis;struct Heap {int size;void push (const node &val) {push_heap (a+1 ,a+size+1 ,cmp);node top () {return a[1 ];void pop () {pop_heap (a+1 ,a+size+1 ,cmp);bool empty () {return size==0 ;0 ;top ();pop ();push (newadd);
priority queue(常数较大): 大根堆(结构体版):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 #include <cstdio> #include <cstdlib> #include <queue> #include <ctime> using namespace std;struct point {int a,b;bool operator <(const point &p)const return a<p.a;int main () srand (time (NULL ));int t1,t2;for (int i=1 ;i<=1000 ;i++)rand ()%1000000000 ;rand ()%1000000000 ;printf ("%d %d\n" ,t1,t2);push (k);printf ("\n" );while (!q.empty ())top ();printf ("%d %d\n" ,k.a,k.b );pop () ;return 0 ;
大根堆:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #include <cstdio> #include <cstdlib> #include <queue> #include <ctime> using namespace std;int >q;int main () srand (time (NULL ));int a;for (int i=1 ;i<=1000 ;i++)rand ()%1000000000 ;printf ("%d " ,a);push (a);printf ("\n" );while (!q.empty ())printf ("%d " ,q.top () );pop () ;return 0 ;
小根堆(结构体版):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 #include <cstdio> #include <cstdlib> #include <queue> #include <ctime> using namespace std;struct point {int a,b;bool operator <(const point &p)const return a>p.a;int main () srand (time (NULL ));int t1,t2;for (int i=1 ;i<=1000 ;i++)rand ()%1000000000 ;rand ()%1000000000 ;printf ("%d %d\n" ,t1,t2);push (k);printf ("\n" );while (!q.empty ())top ();printf ("%d %d\n" ,k.a,k.b );pop () ;return 0 ;
小根堆:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 #include <cstdio> #include <cstdlib> #include <queue> #include <ctime> using namespace std;int ,vector<int >,greater<int > >q;int main () srand (time (NULL ));int a;for (int i=1 ;i<=1000 ;i++)rand ()%1000000000 ;printf ("%d " ,a);push (a);printf ("\n" );while (!q.empty ())printf ("%d " ,q.top () );pop () ;return 0 ;
序列 dp
概念之类的就不说了。例题:P1002 [NOIP 2002 普及组]
过河卒
思路 先弱化问题,先不考虑马的存在。
由于每一次卒只能向下或者向右。 记从 (i,j) 出发,到达终点的路径条数为
f i , j i , j + 1i + 1, j f i , j f i , j + 1f i + 1, j f n , m = 1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #include <bits/stdc++.h> using namespace std;#define MAXN 110 #define ll long long int dx[8 ]={2 ,1 ,-1 ,-2 ,-2 ,-1 ,1 ,2 };int dy[8 ]={1 ,2 ,2 ,1 ,-1 ,-2 ,-2 ,-1 };bool vis[MAXN][MAXN];int n,m,x,y;int main () scanf ("%d%d%d%d" ,&n,&m,&x,&y);true ;for (int i=0 ;i<8 ;++i){if (x+dx[i]>=0 &&x+dx[i]<=n&&y+dy[i]>=0 &&y+dy[i]<=m)true ;1 ;for (int i=n;i>=0 ;i--)for (int j=m;j>=0 ;j--){if (i==n && j==m) continue ;if (vis[i][j])f[i][j]=0 ;else f[i][j]=f[i+1 ][j]+f[i][j+1 ];printf ("%lld\n" ,f[0 ][0 ]);return 0 ;
P1216 [IOI 1994 /
USACO1.5] 数字三角形 Number Triangles
1 2 3 4 5 int i,j;for (j=1 ;j<=n;j++) d[n][j]=a[n][j];for (i=n-1 ;i>=1 ;i--)for (j=1 ;j<=i;j++)max (d[i+1 ][j],d[i+1 ][j+1 ]);
时间复杂度:O (n 2 )d i , j d i + 1, j d i + 1, j + 1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 #include <bits/stdc++.h> #define maxn 510 using namespace std;int d[maxn][maxn],a[maxn][maxn];int n;int max (int a,int b) return a>b?a:b;int main () scanf ("%d" ,&n);for (int i=1 ;i<=n;i++)for (int j=1 ;j<=i;j++)scanf ("%d" ,&a[i][j]);1 ][1 ]=a[1 ][1 ];for (int i=2 ;i<=n;i++)for (int j=1 ;j<=i;j++)max (d[i-1 ][j],d[i-1 ][j-1 ])+a[i][j];int ans=0 ;for (int i=1 ;i<=n;i++) ans=max (ans,d[n][i]);printf ("%d" ,ans);return 0 ;
LIS(最长上升子序列)问题:B3637
最长上升子序列
思路 建立一个数组 s k k s k m i n (b j F j k , 1 ≤ j ≤ i ))s k s k 单调递增 的! 定义 s [k ]k s [k ]i < j s i s j m m < s [j ]m i i s i m s i 单调性得证 ! 所以在求 f i j s j b i b i s j f i j + 1
1.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2
3.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2
1
4.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2
1
2
5.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2
1
2
3
6.
i
1
2
3
4
5
b i 3
7
2
4
6
8
F i 1
2
1
2
3
4
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 #include <bits/stdc++.h> using namespace std;typedef long long ll;const ll MAXN = 1000005 ;int n,a[MAXN],dp[MAXN],R,l,r,ans;int main () for (int i = 1 ;i <= n;++i){0 ]=0 ;0 ;for (int i=1 ;i<=n;++i){if (a[i]>dp[R]){+1 ]=a[i];else {0 ;while (l<=r){int mid = l + r>>1 ;if (dp[mid] < a[i])l = mid+1 ;else {-1 ;int t = 0 ;for (int i = 1 ;i <= n;++i){if (dp[i]!=0 )t++;return 0 ;
最优子结构** 原问题最优,当且仅当子问题最优。大问题的最优解可以由 小问题的最优解推出,这个性质叫做 最优子结构性质**。DP 三连 设计 DP 算法,往往可以遵循 DP 三连:我是谁?
—— 设计状态,表示局面我从哪里来?我要到哪里去? —— 设计转移如何学好 DP 未来将讲到 DP 的各种优化。
e.g. 数据结构优化、斜率优化。 一般而言,DP
的难点,在初学时是如何设计状态 ;在学习深入一些之后,变成了如何设计转移 ;在省选
/ NOI 级别,又变成了如何设计状态 。 学习 DP
主要靠做题练习 。有一些设计状态的思想,需要在具体题目中总结 。线性(序列)模型
线性模型的是动态规划中最常用的模型,上例讲到的最长单调子序列就是经典的线性模型,这里的线性指的是状态的排布是呈线性的。
本类的状态是基础中的基础 ,大部分动态规划都要用到它,成为一个维。
常见的状态设计:
f i i f i i ]i 1 到 i − 1P1434 [SHOI2002]
滑雪
思路 发现这道题目看起来有点像
BFS,于是蒟蒻先想到了找出所有可能成为起点的地方 ,然后进行广搜直到无法向下滑了即可。写的代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 #include <bits/stdc++.h> using namespace std;#define int long long const int MAXN=105 ;int ans,r,c,high;int h[MAXN][MAXN];int snow[MAXN][MAXN];int dx[]={0 ,1 ,-0 ,-1 };int dy[]={-1 ,0 ,1 ,0 };int >q;void bfs (int x,int y) push (x);push (y);while (!q.empty ()){int x=q.front ();pop ();int y=q.front ();pop ();for (int i=0 ;i<4 ;++i){int nx=x+dx[i];int ny=y+dy[i];if (nx>0 &&ny>0 &&nx<=r&&ny<=c&&h[nx][ny]<h[x][y]){max (snow[nx][ny],snow[x][y]+1 );push (nx);push (ny);signed main () scanf ("%lld%lld" ,&r,&c);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j){scanf ("%lld" ,&h[i][j]);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j){bool flag=false ;for (int k=0 ;k<4 ;++k)if (i+dx[k]>0 &&j+dy[k]>0 &&i+dx[k]<=r&&j+dy[k]<=c&&h[i+dx[k]][j+dy[k]]>h[i][j])flag=true ;if (!flag){1 ;bfs (i,j);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j)max (ans,snow[i][j]);printf ("%lld" ,ans);return 0 ;
然后你满怀希望地交上去,发现竟然只拿了90 分!
注意到一个点可能会被加入到队列多次,导致队列膨胀,从而导致
MLE,因此可以这样修改:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 #include <bits/stdc++.h> using namespace std;const int MAXN=205 ;int ans,r,c,high;int h[MAXN][MAXN];int snow[MAXN][MAXN];int dx[]={0 ,1 ,0 ,-1 };int dy[]={-1 ,0 ,1 ,0 };int >q;void bfs (int x,int y) push (x);push (y);while (!q.empty ()){int x=q.front (); q.pop ();int y=q.front (); q.pop ();for (int i=0 ;i<4 ;++i){int nx=x+dx[i];int ny=y+dy[i];if (nx>0 &&ny>0 &&nx<=r&&ny<=c&&h[nx][ny]<h[x][y]){if (snow[nx][ny] < snow[x][y]+1 ){ +1 ;push (nx);push (ny);int main () scanf ("%d%d" ,&r,&c);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j){scanf ("%d" ,&h[i][j]);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j){bool flag=false ;for (int k=0 ;k<4 ;++k)if (h[i+dx[k]][j+dy[k]]>h[i][j])flag=true ;if (!flag){1 ;bfs (i,j);for (int i=1 ;i<=r;++i)for (int j=1 ;j<=c;++j)max (ans,snow[i][j]);printf ("%d" ,ans);return 0 ;
一个经典问题:最长公共子序列 :::info[题目]
题目描述
给定两个序列,求这两个序列的 LCS 长度.
LCS 是 Longest Common Subsequence 的缩写,即最长公共子序列。
一个序列,如果同时是两个已知序列的子序列,且是所有子序列中最长的,则为最长公共子序列。
关于子序列举例说明:
123 的子序列有 8 个:
1
2
3
12
13
23
123
空序列
输入格式
第一行,一个整数n,表示第一个序列的长度;
第二行,n个整数,表示第一个序列;
第三行,一个整数m,表示第二个序列的长度;
第四行,m个整数,表示第二个序列;
输出格式
一个整数,表示所求得的LCS的长度。
输入输出样例 #1
输入 #1
输出 #1
说明/提示
两个序列的最长公共子序列为 1, 2, 4
或 1, 3, 4 。长度为 3 。 对于 100
的测试数据,n , m ≤ 2000f i , j i j
1 2 3 4 if (a[i]!=b[j])max (f[i-1 ][j],f[i][j-1 ]);else -1 ][j-1 ]+1 ;
边界:f[i][0]=0,f[0][i]=0; 代码:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #include <bits/stdc++.h> using namespace std;int a[2010 ],b[2010 ],dp[2010 ][2010 ];int main () int n;for (int i=1 ;i<=n;i++)cin>>a[i];int m;for (int i=1 ;i<=m;i++)cin>>b[i];for (int i=1 ;i<=n;i++)for (int j=1 ;j<=m;j++)if (a[i]==b[j]) dp[i][j]=dp[i-1 ][j-1 ]+1 ;else dp[i][j]=max (dp[i-1 ][j],dp[i][j-1 ]);return 0 ;
背包dp
01背包
这类问题是背包中最简单的问题,有 n 1 n ,其中第 i v i w i c dp[i][j]=max(拿,不拿)。即
d p i , j d p i − 1, j − w i v i d p i − 1, j
先放道模板题:P1048
[NOIP 2005 普及组] 采药
思路 定义状态:d p i , j i j
d p i , j d p i − 1, j − w i v i d p i − 1, j
代码如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #include <bits/stdc++.h> using namespace std;int t,m,w[105 ],v[105 ],dp[105 ][1005 ];int main () for (int i = 1 ;i <= t;++i)scanf ("%d%d" ,&w[i],&v[i]);for (int i = 1 ;i <= t;++i){for (int j = 0 ;j <= m;++j){if (w[i] <= j){max (dp[i - 1 ][j - w[i]] + v[i],dp[i - 1 ][j]);else dp[i][j] = dp[i - 1 ][j];printf ("%d\n" ,dp[t][m]);return 0 ;
实际上,背包问题的时间复杂度已经没办法再优化了。
而空间复杂度还可以优化。在我们之前的算法中,01 背包的空间复杂度是 O (n × m )n m
完全背包
和 01
背包不同的地方在于一个物品可以取无限次,状态转移方程通常为:
d p i , j d p i , j − w i v i d p i − 1, j
例题:B2174
完全背包
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #include <bits/stdc++.h> using namespace std;int t,m,w[1005 ],v[1005 ],dp[1005 ][1005 ];int main () for (int i = 1 ;i <= t;++i)scanf ("%d%d" ,&w[i],&v[i]);for (int i = 1 ;i <= t;++i){for (int j = 0 ;j <= m;++j){if (w[i] <= j){max (dp[i][j - w[i]] + v[i],dp[i - 1 ][j]);else dp[i][j] = dp[i - 1 ][j];printf ("%d\n" ,dp[t][m]);return 0 ;
多重背包
和 01 背包不同的地方在于一个物品可以取多次,并且最多取的次数已给出。
通常这样写:
1 2 3 4 for (int k=0 ;k<=t;++k){if (j<k*p)break ;max (dp[i-1 ][j,dp[i-1 ][j-k*p]+c*k);
例题:B2173
多重背包
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 #include <bits/stdc++.h> using namespace std;#define int long long int n,v;int p,c,t;int dp[505 ][1005 ];signed main () scanf ("%lld%lld" ,&n,&v);for (int i=1 ;i<=n;++i){scanf ("%lld%lld%lld" ,&p,&c,&t);for (int j=0 ;j<=v;++j){for (int k=0 ;k<=t;++k){if (j<k*p)break ;max (dp[i-1 ][j,dp[i-1 ][j-k*p]+c*k);printf ("%lld" ,dp[n][v]);return 0 ;
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 #include <bits/stdc++.h> using namespace std;int n,m;struct Thing {int i;int cost;int q;10005 ];int dp[1005 ];int k;int >v[1005 ];int main () for (int i=1 ;i<=n;++i)scanf ("%d%d%d" ,&a[i].cost,&a[i].q,&a[i].i);max (k,a[i].i);push_back (i);for (int i=1 ;i<=k;++i)for (int j=m;j>=0 ;--j)for (int h=0 ;h<v[i].size ();++h)if (j>=a[v[i][h]].cost)max (dp[j],dp[j-a[v[i][h]].cost]+a[v[i][h]].q);printf ("%d" ,dp[m]);return 0 ;
留几道习题: P5017
[NOIP 2018 普及组] 摆渡车 P2258 [NOIP 2014 普及组]
子矩阵
区间dp
以一道例题来说明:P1775
石子合并(弱化版) 区间动态规划问题一般都是考虑对于每段区间 ,他们的最优值都是由更小几段区间的最优值得到,是分治思想的一种应用 ,将一个区间问题不断划分为更小的区间直至一个元素组成的区间,枚举他们的组合
,求合并后的最优值。 设 f i , j i ≤ j ≤ n )[i , j ]
内的石子合并的最小代价 如何将 f i , j k i j 3 步:
将 [i , k ]
中的石子合并为一堆。
将 [k + 1, j ]
中的石子合并为一堆。
将两堆石子合并。 考虑初值? d p i , i i ≤ n )𝒪(n 3 ) ,可以通过。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 #include <bits/stdc++.h> #define up(a,b,c) for(int (a)=(b);(a)<=(c);(a)=-~(a)) #define dn(a,b,c) for(int (a)=(b);(a)>=(c);(a)=~-(a)) #define fst first #define sed second #define pref static inline #define gc() p1==p2&&(p2=(p1=buf)+fread(buf,1,1<<20,stdin),p1==p2)?EOF:*p1++ using namespace std;using hint = __int128;using pii = pair<int , int >;using us = unsigned short ;using ldb = long double ;using ll = long long ;using ull = unsigned long long ;using ui = unsigned int ;using pll = pair<ll, ll>;using pil = pair<int , ll>;using vpil = vector<pil>;using vl = vector<ll>;using pli = pair<ll, int >;using vpli = vector<pli>;using vi = vector<int >;using vpi = vector<pii>;using vpl = vector<pll>;using db = double ;const int MAXN=305 ;int n;int x,pre[MAXN],f[MAXN][MAXN];namespace mystl {char buf[1 << 20 ],*p1 = buf,*p2 = buf, sr[1 << 23 ], z[23 ], nc;int C =-1 , Z = 0 ;template <typename T>pref void read (T & x) {bool flag = false ;while (nc = gc (), (nc<48 || nc> 57 ) && nc !=-1 ) flag |= (nc == 45 );48 ;while (nc = gc (), 47 < nc && nc < 58 ) x = (x << 3 ) + (x << 1 ) + (nc ^ 48 );if (flag) x = -x;pref void read (char * s) {char ch = gc ();while (ch <= 32 ) ch = gc ();int i = 0 ;while (ch > 32 ) {gc ();'\0' ;pref void read (string &s) {clear ();char ch = gc ();while (ch <= 32 ) ch = gc ();while (ch > 32 ) {gc ();pref void read (char &ch) {gc ();while (ch <= 32 ) ch = gc ();template <typename T, typename ... Args_Arrays_Typename_heffo_hard> void read (T & x, Args_Arrays_Typename_heffo_hard & ...a) {read (x); read (a...);}pref void ot () {fwrite (sr, 1 , C + 1 , stdout ); C = -1 ;}pref void flush () {if (C > 1 << 22 ) ot ();}template <typename T>pref void write (T x) {if constexpr (is_same<T, char >::value) else if constexpr (is_same<T, const char *>::value || is_same<T, char *>::value) {for (int i = 0 ; x[i]; ++i) sr[++C] = x[i];else if constexpr (is_same<T, string>::value) {for (char c : x) sr[++C] = c;else {int y = 0 ;if (x < 0 ) y = 1 , x = -x;0 ;do {10 + 48 ;10 ;while (x);if (y) z[++Z] = '-' ;while (Z) sr[++C] = z[Z--];flush ();template <typename T>pref void write (T x, char t) {write (x);flush ();pref void write (const char * s) {for (int i = 0 ; s[i]; ++i) sr[++C] = s[i];flush ();pref void write (string s) {for (char c : s) sr[++C] = c;flush ();pref ll qpow (ll a, ll b, ll p) {if (a == 0 ) return 0 ;1ll ;while (b){if (b & 1 ) c = a * c % p;1 ;return c;pref ll lcm (ll x, ll y) {return x / std:: __gcd(x, y) * y;using namespace mystl;namespace my {constexpr int P = static_cast <int >(998244353 );pref void madd (int & x, int y) {x = (x + y >= P) ? (x + y - P) : (x + y);}pref int fmadd (int x, int y) {return (x + y >= P) ? (x + y - P) : (x + y);}pref void msub (int & x, int y) {x = (x < y) ? (x - y + P) : (x - y);}pref int fmsub (int x, int y) {return (x < y) ? (x - y + P) : (x - y);}pref void mmul (int & x, int y) {x = (int )(1ll * x * y % P);}pref int fmmul (int x, int y) {return (int )(1ll * x * y % P);}template <typename T>pref T min (T x, T y) {return (x < y) ? (x) : (y);}template <typename T>pref T max (T x, T y) {return (x > y) ? (x) : (y);}template <typename T>pref T abs (T x) {return (x < 0 ) ? (-x) : (x);}constexpr int N = static_cast <int >(0 ), inf = static_cast <int >(0x3f3f3f3f3f );pref void solve () {up (len,2 ,n){for (int i=1 ;i+len-1 <=n;++i){int j=i+len-1 ;for (int k=i;k<j;k++)f[i][j]=min (f[i][j],f[i][k]+f[k+1 ][j]+pre[j]-pre[i-1 ]);write (f[1 ][n]);int main () sync_with_stdio (false );tie (nullptr );tie (nullptr );read (n);memset (f,63 ,sizeof (f));up (i,1 ,n){0 ;read (x);-1 ]+x;solve ();ot ();return 0 ;
四边形不等式优化区间 dp
由于篇幅问题,见 link 。
树形 dp
树形 dp 即在树上进行的 dp,这里给出一个经典例题:P1352 没有上司的舞会
定义 d p i , 0i i d p i , 1i i
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 #include <bits/stdc++.h> #define ll long long #define pii pair<int, int> #define piii pair<pii, int> #define pll pair<ll, ll> #define plll pair<pll, ll> #define pref static inline #define fi first #define se second using namespace std;const int MAXN=16005 ;int n,a,b,root;int bea[MAXN],dp[MAXN][2 ];int >son[MAXN];bool fa[MAXN];namespace heffo_hard{pref void f (int x) {0 ]=0 ;1 ]=bea[x];for (int i=0 ;i<son[x].size ();++i){int y=son[x][i];f (y);0 ]+=max (dp[y][0 ],dp[y][1 ]);1 ]+=dp[y][0 ];pref void solve () {for (int i=1 ;i<=n;++i)cin>>bea[i];for (int i=1 ;i<n;++i){1 ;push_back (a);for (int i=1 ;i<=n;++i){if (!fa[i]){break ;f (root);max (dp[root][1 ],dp[root][0 ]);signed main () sync_with_stdio (0 );cin.tie (0 );cout.tie (0 );solve ();return 0 ;
状态压缩
通常用于一些数据范围小的情况下,给出一道例题。 P10449 费解的开关
我们容易发现,当前行灯的状态只与上一行灯的状态有关,因此我们可以用递推的方法来求解。𝒪(T × 25 × 52 ) = O (800T ) 。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 #include <bits/stdc++.h> #define ll long long #define pii pair<int, int> #define piii pair<pii, int> #define pll pair<ll, ll> #define plll pair<pll, ll> #define pref static inline #define fi first #define se second using namespace std;int dx[4 ]={-1 ,0 ,1 ,0 };int dy[4 ]={0 ,1 ,0 ,-1 };int n;bool light[15 ][15 ],hh[15 ][15 ];char c;int ans,sum;namespace heffo_hard{pref void bfs () {for (int i=1 ;i<=4 ;++i){for (int j=1 ;j<=5 ;++j){if (hh[i][j]==0 ){int ni=i+1 ;1 ;for (int k=0 ;k<4 ;++k){int nx=ni+dx[k];int ny=j+dy[k];if (nx>=1 &&nx<=5 &&ny>=1 &&ny<=5 )1 ;pref void init () {for (int i=1 ;i<=5 ;++i)for (int j=1 ;j<=5 ;++j)pref void solve () {for (int i=1 ;i<=5 ;++i){for (int j=1 ;j<=5 ;++j){-48 ;0x3f3f3f3f ;for (int i=0 ;i<(1 <<5 );++i){init ();0 ;for (int j=1 ;j<=5 ;++j){if (i>>(j-1 )&1 ){1 ][j]^=1 ;for (int k=0 ;k<4 ;++k){int nx=1 +dx[k];int ny=j+dy[k];if (nx>=1 &&nx<=5 &&ny>=1 &&ny<=5 )1 ;bfs ();bool flag=true ;for (int j=1 ;j<=5 ;++j){if (hh[5 ][j]==0 ){false ;break ;if (flag) sum=min (sum,ans);if (sum<=6 ) cout<<sum<<endl;else cout<<-1 <<endl;pref void doing () {while (n--){solve ();signed main () sync_with_stdio (0 );cin.tie (0 );cout.tie (0 );doing ();return 0 ;
最小生成树 & 拓补排序
求最小生成树通常有 2 种方法:
Kruskal
Prim
正确性证明: 选择第一个边的时候,选择的是权值最小的边。显然,该边
是最小生成树的一部分。
否则,将该边加到最小生成树中,则形成回路,让该边取代回路
中比这个最小边权值大的边,仍然得到最生成树,但该生成树比
所得到的最小生成树还要小,这与假设矛盾。因此第一次选取的
最小边,一定是最小生成树的一部分 现在假设选取的前 s
条边是最小生成树的一部分,这些边连 接的节点记做 n 1 n 2 n s + 1s + 1P3959 [NOIP 2017 提高组]
宝藏
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 #include <bits/stdc++.h> #define maxn 12 #define inf 1061109567 using namespace std;int n,m,u,v,c,tmp,sum,rest,ans;int dis[maxn+3 ][maxn+3 ],g[(1 <<maxn)+10 ],dp[maxn+3 ][(1 <<maxn)+10 ];int main () scanf ("%d%d" ,&n,&m);memset (dis,63 ,sizeof (dis));memset (dp,63 ,sizeof (dp));for (int i=0 ;i<n;++i) {0 ][1 <<i]=0 ;0 ;for (int i=1 ;i<=m;++i){scanf ("%d%d%d" ,&u,&v,&c);min (dis[v][u],c);int lim=(1 <<n)-1 ;for (int i=1 ;i<=lim;++i){for (int j=0 ;j<n;++j) if (i&(1 <<j))for (int k=0 ;k<n;++k) if (dis[j][k]<inf) g[i]|=(1 <<k);for (int i=2 ;i<=lim;++i){for (int s=i-1 ;s;s=(s-1 )&i){if ((g[s]&i)==i){0 ;for (int j=0 ;j<n;++j)if (rest&(1 <<j)){for (int k=0 ;k<n;++k) if (s&(1 <<k)) tmp=min (tmp,dis[j][k]);for (int k=1 ;k<=n;++k) if (dp[k-1 ][s]<inf) dp[k][i]=min (dp[k][i],dp[k-1 ][s]+k*sum);for (int i=0 ;i<=n;++i) ans=min (ans,dp[i][lim]);printf ("%d" ,ans);return 0 ;
由于每条边的实际权值,与该条边是生成树上的“第几层”有关。因此考虑“一层一层 ”地去生成整棵树。
简单来说,思路就是,先确定根 ,然后选出一些与根相连的点成为树的第一层,再根据规则选出第二层,再根据规则选出第三层…
考虑在任意时刻,我们关心的只有我们已经把多少点加进生成树了,以及生成树的最大树高 是多少。状态压缩 记录下当前已经加入生成树的点的集合。
d p i , S i S
d p i , S d p i − 1,S ′ p a y )
其中满足 S ′ S S ′ S pay
是这次加边的花费。
如何枚举 S S ′ S K S $K \And S =K$ ?2n
种,每一种 S 2n
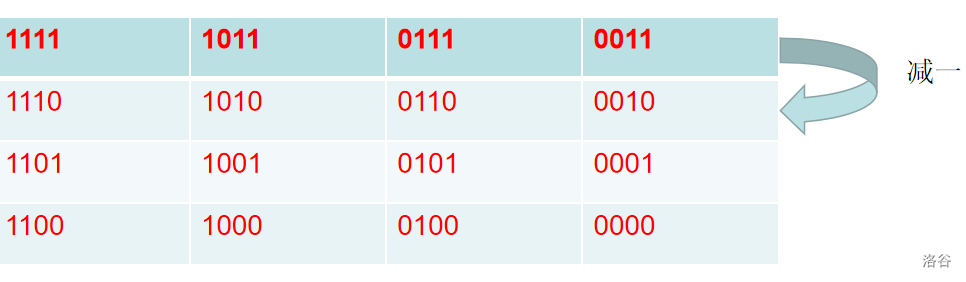
种集合并判断,时间复杂度需要 𝒪(4n 。1111 for(int i=15;i>=0;--i)0
怎么办?k = 110110S k for(i=k;i;i=(i-1)&k) 根据数学知识,i − 1i 1 减一,其右边的所有 0 变为 1 。
红色部分我们称作“有效部分”,黑色部分称作“无效部分”。但”右边的所有 0 变为 1
”可能使得最右边1右边的无效部分也由 0 变
1 。 再按位与上k相当于把右边产生的 1 中,该是 0
的部分变回 0 。
子集枚举的时间复杂度分析:
最外重循环枚举的元素个数为k的子集个数为C(n,k)个,每个这样的集合有2k个子集。
则所有子集个数 =
C n 0 20 + C n 1 * 21 + ... + C n n n
二项式定理:
(a + b )n C n 0 a 0 b n C n 1 a 1 b n − 1C n n a n b 0
所有子集个数 = (2 + 1)n n 。S ′ S ′ g S S S ′
$$
(g_{S'}\And S)=S
$$
如何计算本次加边的总花费 p a y i i s u m i p a y r e s t = S ⊕ S ′ r e s t i S ′ + r e s t S r e s t j S ′ j t m p sum+=tmp。i S S ′ r e s t r e s t r e s t 3 累加进最小生成树不是会“算多了”吗?3
小,那么这样不会丢失更优解吗?
单源最短路
通常有 2 种算法:
SPFA 复杂度 𝒪(n 2 ) ,通常用于数据范围较小/有负权边的题目。
Dijkstra 复杂度 𝒪(n l o g n ) ,通常用于数据范围较大/无负权边的题目。
给出 2 道例题: P3371
【模板】单源最短路径(弱化版) 这道题的数据范围比较小,直接用 SPFA
即可。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 #include <bits/stdc++.h> using namespace std;const int MAXN = 10005 , MAXM = 500005 ;const int INF = 0x3f3f3f3f ;int n, m, s, t, num, x, y, z;int to[2 * MAXM], first[MAXN], nxt[2 * MAXM], w[2 * MAXM], dist[MAXN];bool inqueue[MAXN];void add (int u, int v, int weight) void SPFA (int s) memset (dist, 0x3f , sizeof (dist));memset (inqueue, 0 , sizeof (inqueue));int > q;0 ;1 ;push (s);while (!q.empty ())int u = q.front ();pop ();0 ;for (int i = first[u]; i; i = nxt[i])int temp = to[i];if (dist[temp] > dist[u] + w[i])if (!inqueue[temp])push (temp);1 ;int main () for (int i = 1 ; i <= m; ++i)add (x, y, z); SPFA (s);for (int i = 1 ; i <= n; ++i){if (dist[i] == INF) cout << 2147483647 << ' ' ; else cout << dist[i] << ' ' ;return 0 ;
P4779
【模板】单源最短路径(标准版) 这道题就需要使用 Dijkstra
算法了。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 #include <bits/stdc++.h> using namespace std;const int MAXN = 100005 , MAXM = 2000005 ;const int INF = 0x3f3f3f3f ;int n, m, s, t, num, x, y, z;int to[2 * MAXM], first[MAXN], nxt[2 * MAXM], w[2 * MAXM], dist[MAXN];bool inqueue[MAXN];void add (int u, int v, int weight) void Dijkstra (int s) memset (dist, 0x3f , sizeof (dist));int , int >, vector<pair<int , int >>, greater<pair<int , int >>> pq;0 ;push ({0 , s});while (!pq.empty ())auto [d, u] = pq.top ();pop ();if (d != dist[u])continue ; for (int i = first[u]; i; i = nxt[i])int v = to[i];if (dist[v] > dist[u] + w[i])push ({dist[v], v});int main () for (int i = 1 ; i <= m; ++i)add (x, y, z); Dijkstra (s);for (int i = 1 ; i <= n; ++i)if (dist[i] == INF)2147483647 << ' ' ;else ' ' ;return 0 ;
拓扑排序的例题:P1137 旅行计划
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 #include <bits/stdc++.h> using namespace std;const int MAXN = 100005 ;int n, m, x, y;int first[MAXN], nxt[2 * MAXN], to[2 * MAXN], num, f[MAXN];void add (int u, int v) int dp (int i) if (f[i] > 0 )return f[i];1 ;for (int j = first[i]; j; j = nxt[j])max (f[i], dp (to[j]) + 1 );return f[i];int main () scanf ("%d%d" , &n, &m);for (int i = 1 ; i <= m; ++i)add (y, x);for (int i = 1 ; i <= n; ++i)dp (i);for (int i = 1 ; i <= n; ++i)
所有点对间的最短路
通常使用 Floyd 算法。𝒪(n 3 ) 。 模板题:B3647
【模板】Floyd d p k , u , v k u , v u v d p k , u , v m i n (f k − 1, u , v d p k − 1, u , k d p k − 1, k , v d p u , v m i n (d p u , v d p i , k d p k , j
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 #include <bits/stdc++.h> using namespace std;const int MAXN = 105 ;int n,m,x,y,w;int dp[MAXN][MAXN];void Floyd () for (int k = 1 ; k <= n; k++)for (int i = 1 ; i <= n; i++)for (int j = 1 ; j <= n; j++)min (dp[i][j], dp[i][k] + dp[k][j]);int main () scanf ("%d%d" , &n, &m);memset (dp, 0x3f3f , sizeof (dp));for (int i = 1 ; i <= n; i++)0 ;for (int i = 1 ; i <= m; i++)scanf ("%d%d%d" , &x, &y,&w);min (dp[x][y],w);min (dp[x][y],w); Floyd ();for (int i=1 ;i<=n;++i){for (int j=1 ;j<=n;++j){' ' ;return 0 ;
最近公共祖先
最近公共祖先即 LCA,是两个点的所有祖先中深度最大的那一个。 LCA
通常使用倍增法来求解。 模板题:P3379
【模板】最近公共祖先(LCA) f i , j i 2j 级祖先。 我们可以通过
DFS 来预处理出 f 2 个点
x , y 3 步来完成。
将 x , y x y
1 if (dep[x]<dep[y])swap (x,y);
然后把 x d e p x d e p y x , y
1 2 3 4 5 6 7 int g=dep[x]-dep[y];int i=1 ;while (g){if (g&1 )x=f[x][i-1 ];1 ;
将 x , y x , y x , y
1 2 3 4 5 6 if (x==y)return x;for (int i=20 ;i>=0 ;--i)if (f[x][i]!=f[y][i]){
返回 x , y
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 #include <bits/stdc++.h> using namespace std;const int MAXN=500005 ;const int MAN=log2 (500005 )+5 ;int n,q,root;int x,y;int first[MAXN],nxt[2 *MAXN],to[2 *MAXN],num;int a,b;int dep[MAXN];int f[MAXN][MAN];void init () for (int j=1 ;(1 <<j)<=n;++j)for (int i=1 ;i<=n;++i)-1 ]][j-1 ];void add (int u,int v) void dfs (int x,int fa) for (int i=first[x];i;i=nxt[i]){if (to[i]==fa)continue ;+1 ;0 ]=x;dfs (to[i],x);int lca (int x,int y) if (dep[x]<dep[y])swap (x,y);int g=dep[x]-dep[y];int i=1 ;while (g){if (g&1 )x=f[x][i-1 ];1 ;if (x==y)return x;for (int i=20 ;i>=0 ;--i)if (f[x][i]!=f[y][i]){return f[x][0 ];int main () for (int i=1 ;i<n;++i){add (x,y);add (y,x);dfs (root,0 );init ();for (int i=1 ;i<=q;++i){printf ("%d\n" ,lca (x,y));return 0 ;
线段树&树状数组
线段树
线段树是一个非常好用的东西,可以解决许多动态维护的问题。
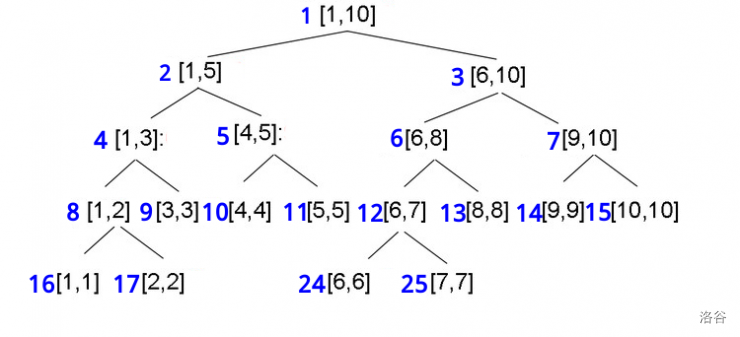
线段树的每个节点都对应一个整数区间. 一般的,对于维护长度为N 1 ,对应的区间为[1, N ] . 对于编号为i [l , r ] 的节点:
(1)若l < r i $\frac{l+r}{2}$ 向下取整的值为 m i 2 × i ,对应的区间为 [l , m ] ,i 2 × i + 1 ,对应的区间为 [m + 1, r ] ;
(2)若 l = r i 2i 和2i + 1 的节点.
例如,当 N = 10
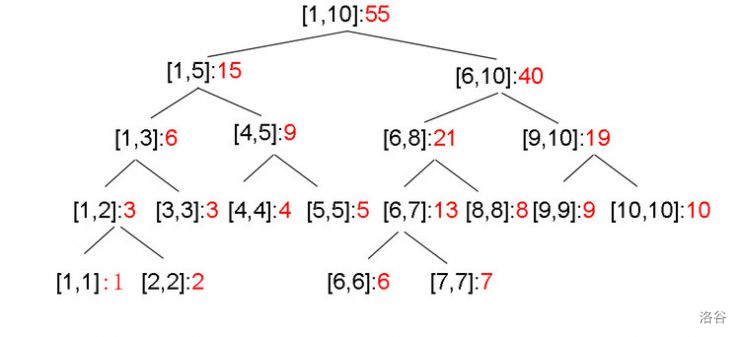
另外,每个节点i a i N s 1 , s 2 , s 3 , ..., s N i [l , l ] ,则a i s l i a i a 2i + a 2i + 1 N = 10s 1, 2, 3, ..., 10
时,各节点值如下图所示(图中区间右边红色的数即该节点的值,节点编号未标出,可参考上图)。
不难发现,区间为 [l , r ] 的节点 i a i s l s l + 1s l + 2s r s [l , r ] 的和.
线段树支持以下两种基本操作:
查询序列s [l , r ] 的和. 对任意 1 ≤ l ≤ r ≤ N ,区间
[l , r ]
总能拆成若干个线段树上的区间,例如查询 [3, 8] 的区间和,在根节点处以 5 为分割点分成 [3, 5] 和 [6, 8] 两段,[3, 5] 在节点 2 处以 3
为分割点分成了 [3, 3] 和 [4, 5] 两段,这两段都在线段树上;[6, 8] 完全在节点3 的中点左侧,往左子树可找到 [6, 8] 在线段树上. 若记 S (l , r ) = s l s l + 1s l + 2s r
S (3, 8) = S (3, 5) + S (6, 8) = S (3, 3) + S (4, 5) + S (6, 8) = 3 + 9 + 21 = 33
这样的区间个数是 𝒪(log N )
的,所以可以高效完成查询.
修改序列的某一项s i 1 向下查找得到区间[i , i ] 的所在节点,当然这一项的变化还会导致其它有关节点的变化,所以要更新查找过程中所有经过的节点的值.
比如我们要修改 s 7 3 ,可以二分查找,经过以下节点:1, 3, 6, 12, 25 ,更新a 25 = 3[6, 7] 的和变成了6 + 3 = 9 ,于是还得再更新父节点a 12 = 9
a 6 = 9 + 8 = 17a 3 = 17 + 19 = 36a 1 = 15 + 36 = 51
现在如果要查询上述的 [3, 8]
的区间和,那么就会变成
S (3, 8) = S (3, 3) + S (4, 5) + S (6, 8) = 3 + 9 + 17 = 29
修改序列的一项,更新的线段树节点个数是O (log N )P3372
【模板】线段树 1 模板题,实现区间修改与区间查询。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 #include <bits/stdc++.h> #define ll long long #define pii pair<int, int> #define piii pair<pii, int> #define pll pair<ll, ll> #define plll pair<pll, ll> #define pref static inline #define fi first #define se second using namespace std;const ll MAXN=1000005 ;int op;namespace heffo_hard{pref void push_down (ll root,ll l,ll r) {if (lazy[root]){1 ;1 ]+=lazy[root]*(mid-l+1 );1 |1 ]+=lazy[root]*(r-mid);1 ]+=lazy[root];1 |1 ]+=lazy[root];0 ;pref void update (ll root,ll l,ll r) {if (x<=l&&r<=y){+1 );return ;push_down (root,l,r);1 ;if (x<=mid)update (root<<1 ,l,mid);if (y>mid)update (root<<1 |1 ,mid+1 ,r);1 ]+sum[root<<1 |1 ];pref void build (ll root,ll l,ll r) {if (l==r){return ;1 ;build (root<<1 ,l,mid);build (root<<1 |1 ,mid+1 ,r);1 ]+sum[root<<1 |1 ];pref void query (ll root,ll l,ll r) {if (x<=l&&r<=y){return ;push_down (root,l,r);1 ;if (x<=mid)query (root<<1 ,l,mid);if (y>mid)query (root<<1 |1 ,mid+1 ,r);pref void solve () {scanf ("%lld%lld" ,&n,&q);for (ll i=1 ;i<=n;i++)scanf ("%lld" ,&a[i]);build (1 ,1 ,n);for (ll k=1 ;k<=q;++k){scanf ("%lld" ,&op);if (op==1 ){scanf ("%lld%lld%lld" ,&x,&y,&v);update (1 ,1 ,n);if (op==2 ){scanf ("%lld%lld" ,&x,&y);0 ;query (1 ,1 ,n);printf ("%lld\n" ,ans);signed main () sync_with_stdio (0 );cin.tie (0 );cout.tie (0 );solve ();return 0 ;
树状数组
树状数组是一种可以高效实现前缀和查询和单点修改的数据结构。𝒪(log n )
的时间复杂度内完成前缀和查询和单点修改操作。
用树状数组能做的,用线段树都能做,用线段树能做的,树状数组不一定能做。
树状数组的基本思想是通过维护一个数组 c c [i ]i i − l o w b i t (i ) + 1l o w b i t (i )i 1 所在的位置。c i c i c i + l o w b i t (i )P3374
【模板】树状数组 1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 #include <bits/stdc++.h> using namespace std;const int MAXN=5E5 +5 ;int n,m;int a[MAXN];int s[MAXN];int op,x,y;int lowbit (int x) return x&(-x);}int query (int x) int res=0 ;for (int i=x;i;i-=lowbit (i))res+=s[i];return res;void update (int x,int y) for (int i=x;i<=n;i+=lowbit (i))s[i]+=y;int main () scanf ("%d%d" ,&n,&m);for (int i=1 ;i<=n;++i){scanf ("%d" ,&a[i]);update (i,a[i]);while (m--){if (op==1 ){update (x,y);else {printf ("%d\n" ,query (y)-query (x-1 ));return 0 ;
 如果深度为
k 的二叉树共有 2k − 1
个结点,我们称之为满二叉树。 给定一棵包含 2k − 1 个结点的满二叉树
(k
为树的深度),如果把结点从上到下,从左到右依次编号为 1, 2, 3…,则结点 i 的左右子结点编号分别为 2 × i 和 2 × i + 1。 结点 i 的父亲结点为 $\frac{i}{2}$。 深度为 k,有 n
个结点的二叉树当且仅当其每一个结点都与深度为 k 的满二叉树中编号从 1 到 n
的结点一一对应时,称为完全二叉树。
满二叉树都是完全二叉树。但完全二叉树不一定都是满二叉树。
 如图所示的基本结构,记录:
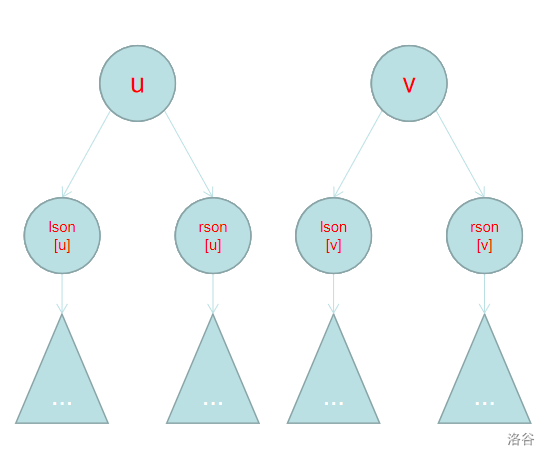 如图所示:如果以
u 为根的子树和以 v 为根的子树对称,当且仅当:
 优化:路径压缩
我们虽然不关心树的形态,但我们仍然希望树尽量越矮越好,这样不至于在“往上爬”的过程中耗费太多的时间。
在查询过程中向上经过的所有的节点,都改为直接连到根上:
 并查集之路径压缩:
每次查询时将路径上所经过的点记录下来,查询到根节点后,让这些点直接连向根节点?
不必那么麻烦,递归实现,毫不费力:
 当然,堆的形态不是唯一的,但我们不关心堆的形态,只需要它满足堆的性质即可。这样所有的结点权值都小于等于它的子孙结点,因此整棵二叉树的根节点(堆顶元素)一定是所有结点中权值最小的结点。
堆需要支持的操作:
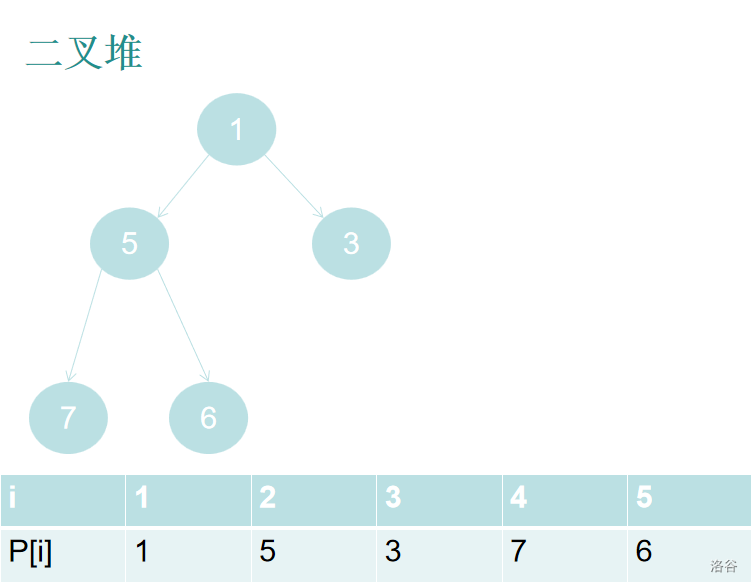 此时堆的
size 为
5,表示堆中一共有五个元素。
 取出堆顶元素
1 后,维护堆的平衡靠以下操作实现:
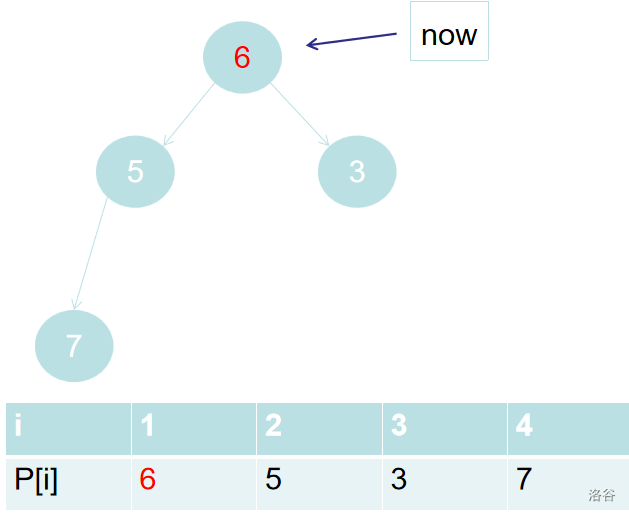
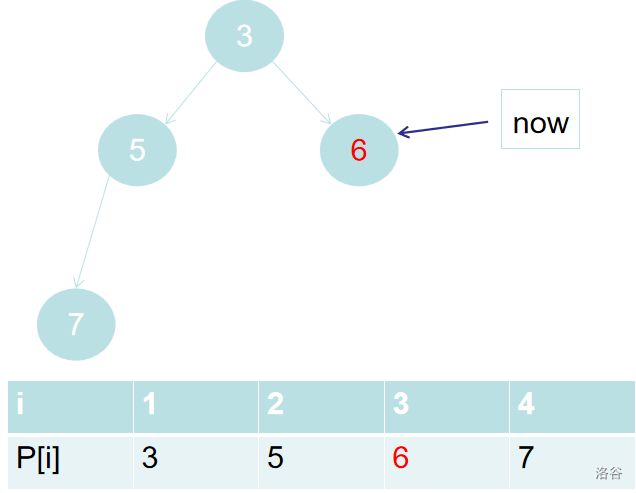 代码:
 参考程序:
 如果原集合不是全集,而带有一些 0
怎么办?
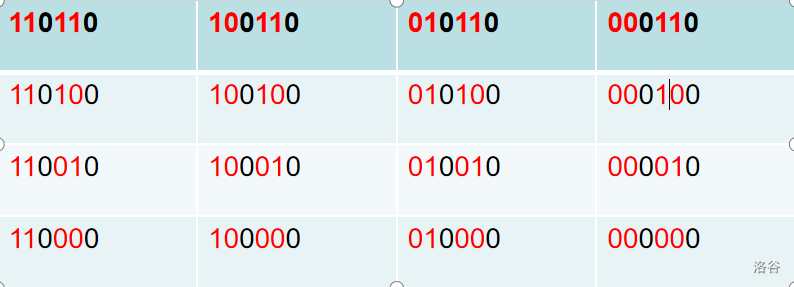 其实就是将原数字上为“零”的位置忽略,参照上表一样做减一操作,后再统一往被忽略的位置上填上“零”。这样就可以枚举出
S 的所有子集了。
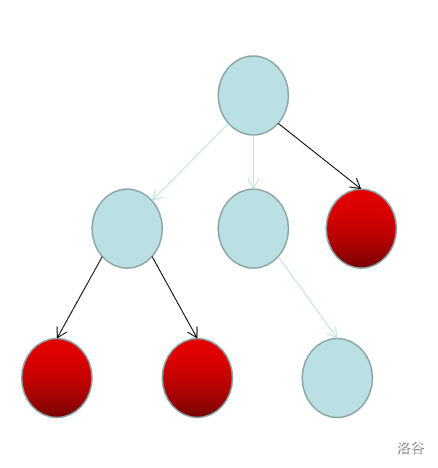 如图所示树所有点为集合 S。
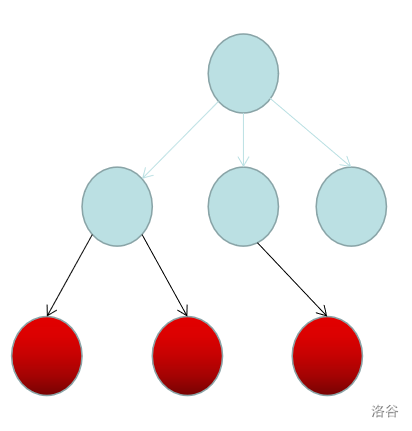 不会丢失最优解,因为一定存在一种如图所示的加边方案比刚才更小。